AI给煤矿安检装上”第二双眼睛”
眼睛毒,是几十年的经验熬出来的。但一个人的”毒眼”,全矿几千台设备都靠它吗?这就是我们做这个项目的起点。不是觉得某个谁不行,而是客观上,传统巡检模式走到了一个瓶颈——靠人眼、靠经验、靠自觉,越到后期越难维持。
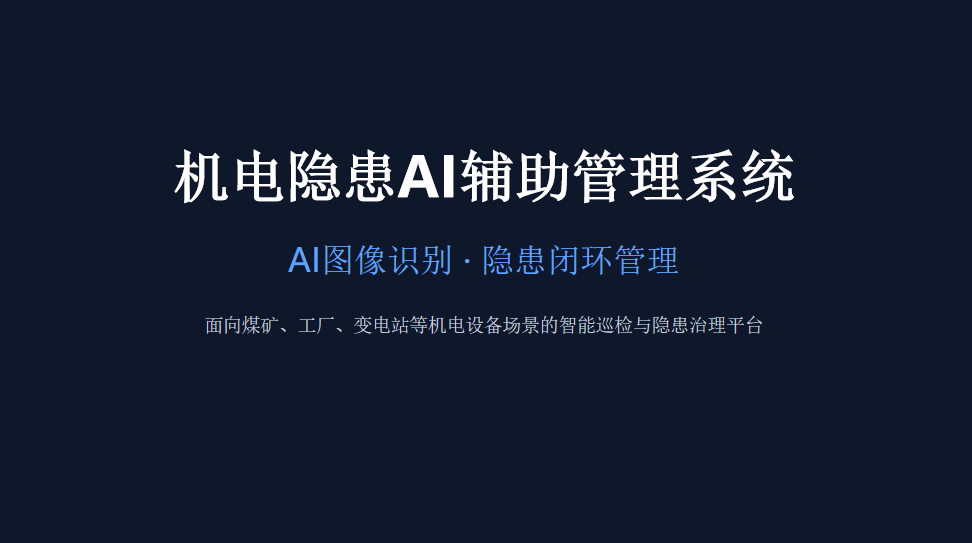
问题出在哪儿?说透了三件事
一 井下条件摆在那儿
巷道昏暗、粉尘弥漫、设备密集。巡检人员提着手电,挨个设备看壳体裂纹、看螺栓松动、看铭牌清晰。这些东西在明亮的车间里用放大镜都不一定看得准,在井下靠着手机摄像头拍照检查,难度有多大,业内人士都清楚。
二 标准是死的,人是活的
防爆标准涉及大量专业参数和条款。一个接线嘴的压紧程度算不算失爆?外壳紧固件缺失几个要记为重大隐患?不同安检员的判断尺度差得远。同样的问题,张三说没事,李四说严重,下面的人无所适从。
更现实的是——经验丰富的老安检员带不动那么多新人。 二十年练就的”一眼准”,新来三年根本学不会。人的经验没法批量复制,这是硬伤。
三 拍照上传之后呢?
照片拍了,工单下了,整改完了,销号了。完了?
完了。照片散落在每个人的手机相册里,谁也没系统整理过。这些照片背后藏着大量设备健康信息——哪台设备的锈蚀频率最高、哪个班组的返工率最大、哪类隐患反复出现——但没人去看,数据白白浪费。
这三件事叠加起来,结果就是:隐患该发现的没发现,不该判重的判重了,找到了也不一定改到位,数据资产沉睡了,管理层心里没底。
这套系统,到底在干什么?
一句话概括:拍照,AI挑毛病,自动生成整改工单。
但实现逻辑并不简单。我们用了”CV专用视觉模型 + VLM视觉语言大模型”的双层架构——说白了就是一”专”一”广”的配合。
第一个角色:懂”看图”的AI工人
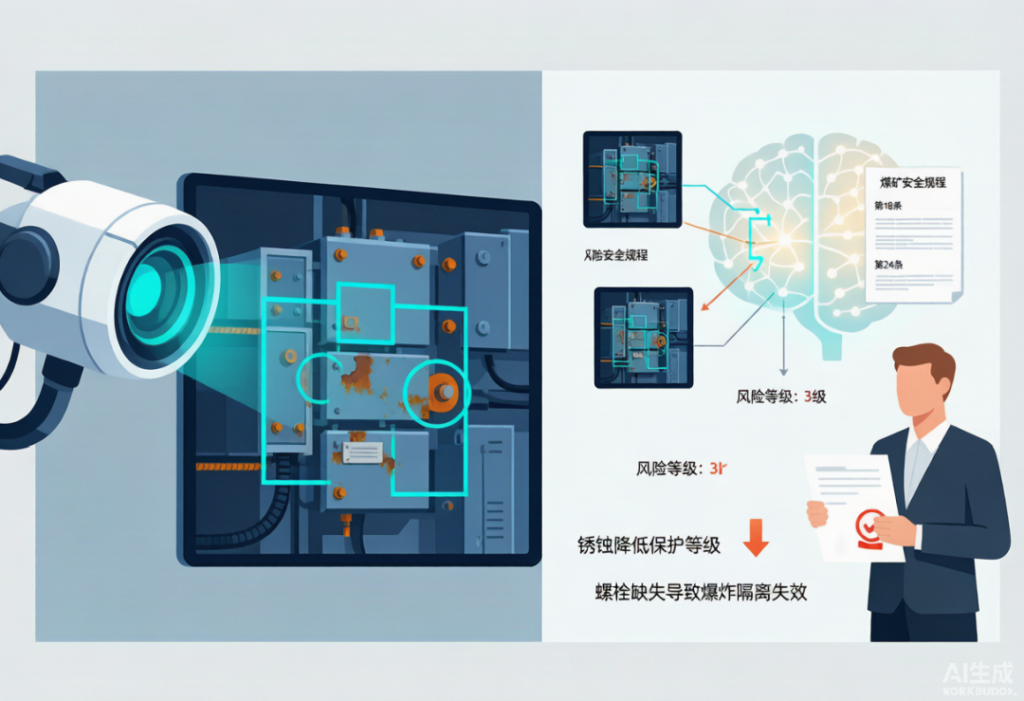
这部分用的是目标检测模型和缺陷分割模型。它的任务是客观地回答一个问题:图片里有什么?
具体做什么?它能在照片里精确圈出——壳体哪里生锈了、哪个螺栓缺了、铭牌编号是多少、皮带跑偏了多少毫米。这些输出都是客观特征,不涉及主观判断,不给出结论,只陈述事实。
就像一位极其仔细的检查员,不放过任何细节,但他只管发现问题,不管怎么定性。
第二个角色:懂”分析”的AI专家
仅有”发现了什么”是不够的。你还得知道:发现这些问题意味着什么?
这一步交给视觉语言大模型(VLM)。它把三样东西放在一起综合判断:原始图片、第一个模型的识别结果、以及《煤矿安全规程》中对应的标准条文。
它能理解”接线盒外壳生锈”不只是一个外观问题——外壳锈蚀会降低防护等级,增加电气失爆的风险。它能判断”螺栓缺失”不只是少了一颗螺丝——防爆面间隙可能超标,隔爆功能就此失效。
它综合这些信息后,会生成一份规范化的报告:什么地方出了什么问题、风险在哪里、应该怎么整改、哪些指标需要人工复核。
注意”复核”这两个字。 有些隐患——比如间隙测量、内部拆检、绝缘测试——AI通过一张照片是看不出来的。系统不会替你做这个决定,而是明确提示:”此处需人工复核”。AI不替人拍板,最终决策权始终在人手里。
五步走,闭环管理
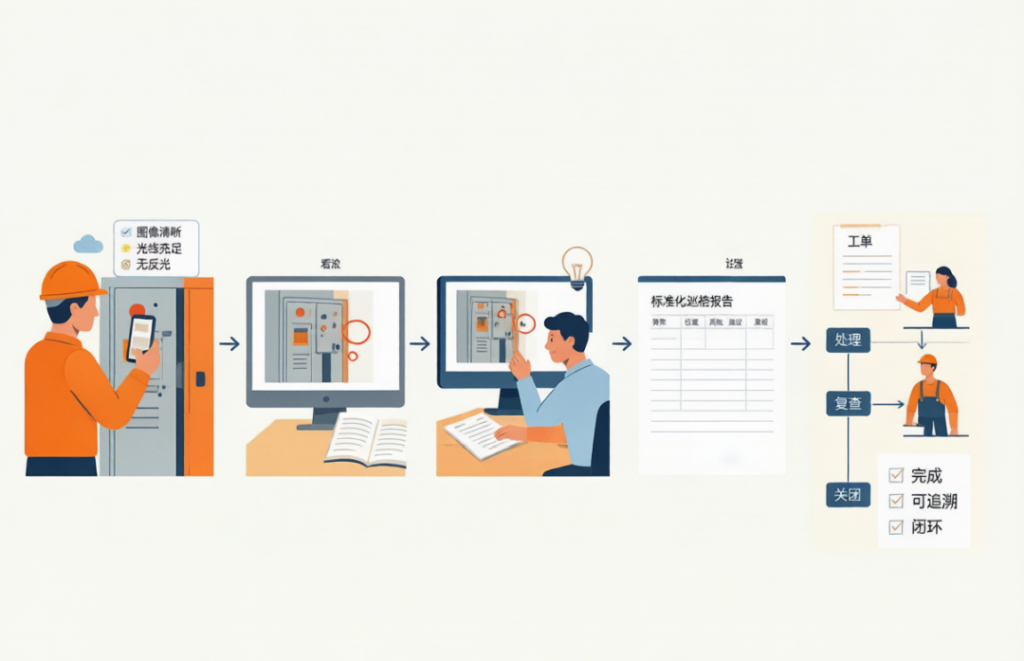
整个流程概括起来就是五步:拍 → 看 → 想 → 说 → 管
- 拍 —— 拍照后系统先判断图片质量:光线不够、画面模糊,直接提示重新拍摄,源头保证数据可用;
- 看 —— CV模型提取客观特征:”这里锈了””那个螺栓没了”;
- 想 —— 大模型综合分析,理解这些特征背后的安全风险;
- 说 —— 自动生成标准化报告:异常描述、对应部位、风险提示、整改建议、复核要求,五个字段清清楚楚;
- 管 —— 规则匹配工单派发:按隐患等级自动推送给责任班组,整改完成后拍照上传销号,全流程留痕可追溯。
背后用了多大功夫?
很多人第一反应是:”这不就是一个AI识别嘛,有什么难的?”
真不简单。
首先要有数据
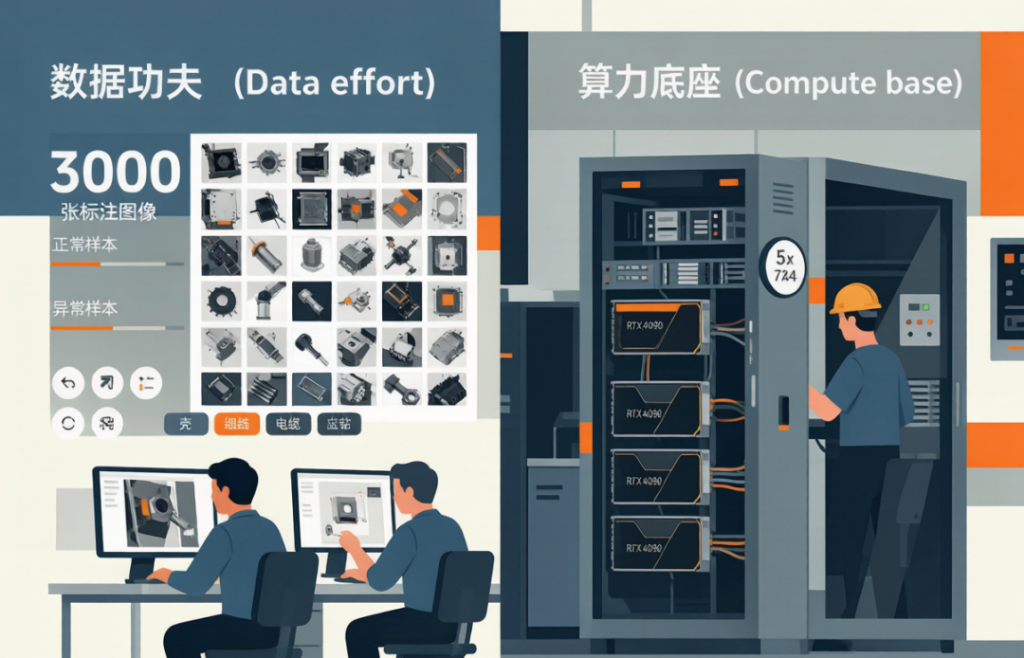
系统不是凭空学会的。项目首期我们建立了不少于3000张标注图像的数据集——1000张正常状态的照片作为基准,2000张异常隐患的照片用于训练。这2000张要覆盖15个大类场景,包括壳体异常、紧固件异常、接线嘴异常、电缆问题、皮带跑偏等,细分项达30到40个。
每个细分项起步至少需要40到60张原始标注图片,直接喂给模型训练的约30到50张。单个类别如果只有四五十张照片,模型大概率会欠拟合。怎么办?我们采取了几招:
- 迁移学习:用已经在海量通用图像上训练好的预训练模型做底座,井下的数据只做微调,大幅降低了样本需求;
- 数据增强:旋转、裁剪、亮度变换、加噪声,一张原始照片可以扩充成5到10张衍生样本,单类别实际训练量可达200到400张;
- 多任务复用:一张图同时用来做目标检测和图像分类,最大化利用价值。
而且3000张只是一个起点。系统上线后,现场误报漏报的样本会自动回流,持续补充到数据集中。我们计划的运行期目标是把样本库充实到8000到10000张,实现精度的一路攀升。
其次要有算力
跑了这么多模型,算力跟不上等于空谈。
我们配置了三台NVIDIA RTX 4090显卡组成的算力集群。其中一张专门负责轻量化的CV视觉识别任务,另外两张联动支撑庞大的VLM大模型推理运算——单张图像从拍摄到识别出结果控制在5秒以内。配上双路32核心的Intel处理器、128GB DDR5内存和专业RAID存储阵列,整套系统7×24小时不间断运行,没有多余的废话,就是追求稳定可靠。
这件事真正改变的是什么?
技术层面的东西讲得再多,落到管理上才见真章。
全矿执行同一套标准
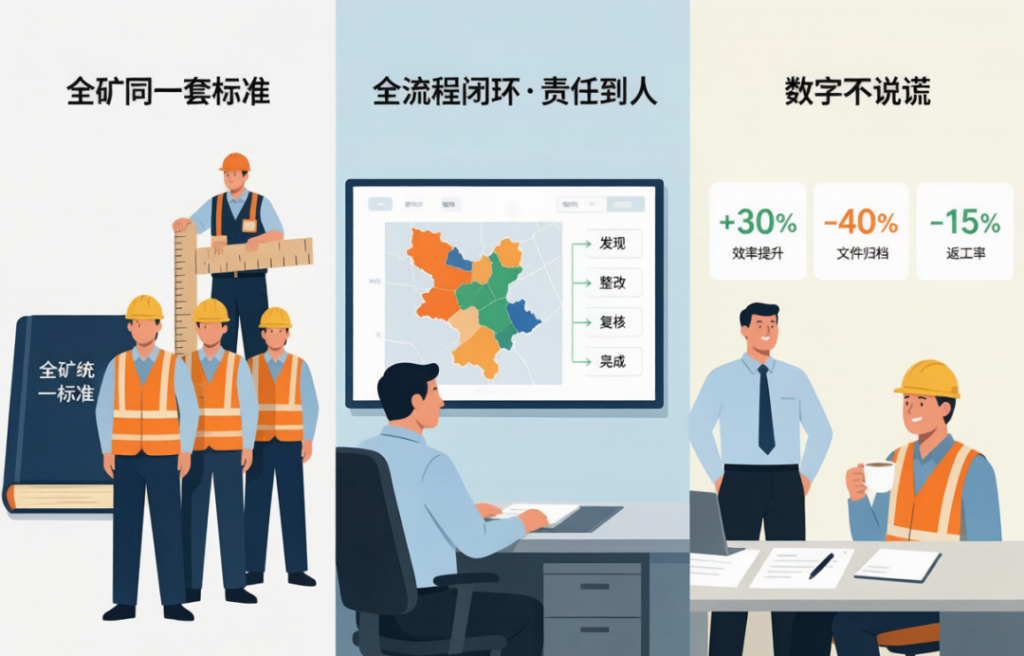
最直观的改变是——消除了”张三和李四不一样”的问题。 以前不同的队伍、不同的人,检查标准各有理解。现在系统就是”一把尺子量到底”。将几十年积累的巡检经验和标准固化到系统中,不因为人员流动而受影响。
全流程闭环,责任到人
隐患从发现到整改到复核,每个环节全程留痕、数据不可篡改。管理层随时可以查看全矿机电设备健康度分布——哪个区域隐患多、哪类问题最频繁、哪个班组返工率高——一目了然,心里有数。
数字不说谎
据测算:
- 巡检效率提升 30%以上 —— 原来需要拍照、记录、填表的流程,现在只需拍一张照;
- 隐患资料整理和建档时间减少 40%以上 —— 系统全自动结构化建档,彻底告别手工翻找整理;
- 整改返工率降低 15%以上 —— 因为系统给出了精准的整改建议,班组一次性就能改到位。
30%、40%、15%,这些数字背后是什么?是每个安检员每天省下来的时间,是每个班组少跑冤枉路的成本,是每个管理层少熬夜整理的台账。
最后说几句心里话
做这个项目,不是为了追技术热点,也不是为了搞面子工程。核心动因只有一个:让每一位安检员都有老专家的判断力,而不是指望某几个人成为不可替代的”活字典”。
这套系统,本质上是在做一件事——把前辈们数十年积累的经验变成全矿员工都能随时调用的数字资产。这不是对传统的否定,而是对经验的传承与放大。
技术再先进,初心不能变:保护好每一位矿工兄弟的安全与健康。这,就是我们做这件事最根本的理由。